加 grafts 為何退步
V24 用 9 個 patch 拿到 2.56。我假設在 V24 config 上加 7 個 TAAF grafts 應該複合到 LB 3.0+。結果 V25 加了 7 個 grafts,但用的是 thtennant fork,這個 fork 不含 V24 的 4 個關鍵 patch。LB 1.42,比 V24 -1.14。退步不是 grafts 本身造成的,是遺失的 patch 造成的。
V24 + grafts 應該複合的假設
V24 用 9 個 patch 拿到 2.56。我假設在 V24 config 上加 7 個 TAAF grafts(winframe、goalkeep、clockwatch、hudmask、clickmap、searchmap、lawbook)應該複合到 LB 3.0+。
Grafts 從 thtennant/taaf-kaggle-source-share-fork port 過來。每個 graft 加一個特定 instrumentation layer:
- winframe:偵測 win condition 何時達成
- goalkeep:跨 level 追蹤 goal state
- clockwatch:監控每 level 時間
- hudmask:在 vision input 上覆蓋 HUD 資訊
- clickmap:追蹤 click 位置
- searchmap:追蹤已探索區域
- lawbook:維護 rule library
預期是這些 grafts 會給 solver 更多資訊,改善 LB。
為什麼用 thtennant fork
用 thtennant/taaf-kaggle-source-share-fork 當 source bundle。7 個 grafts 透過 TAAF_GRAFTS_FLAGS env var 啟用。
Graft 安裝已驗證:stdout 顯示 TAAF_GRAFTS FEATURES={"clickmap":true,...,"winframe":true} API_VERSION=1 與個別 [goalkeep] armed、[hudmask] armed 等 line。7 個 graft 各自的 marker 都有出現。
但 thtennant fork 不含 V24 patches。這個 fork 基於舊版 TAAF,缺少:
- FP8 KV cache(沒有
ENABLE_FP8_KV=True) - Writable bundle copy(沒有
refreshing writable bundle copy) - Reasoning effort cap(沒有
reasoning_effort: 'high') - Noop guard 驗證(沒有
hard_noop_guard = True)
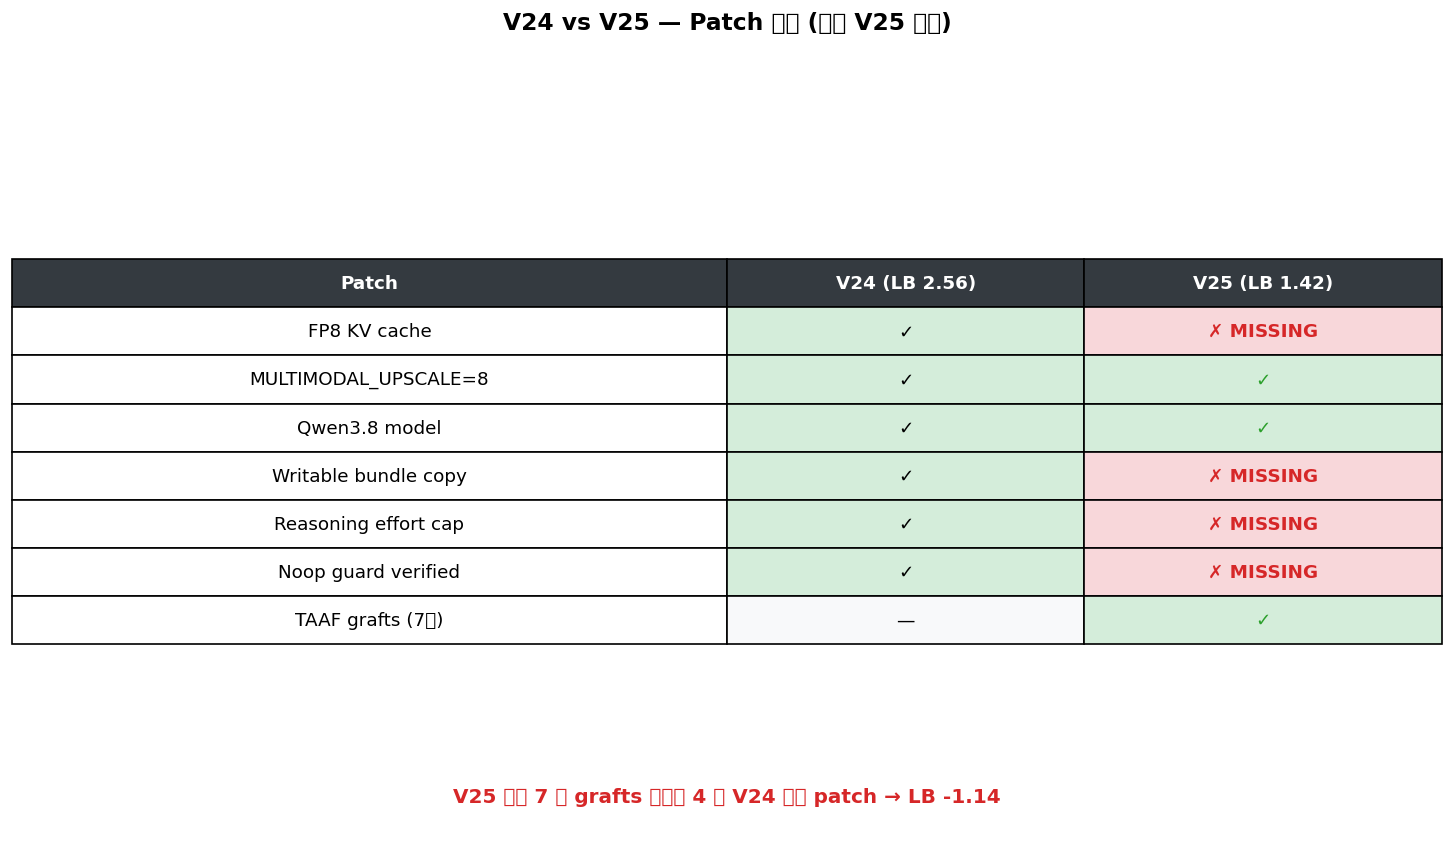
V25 有 MULTIMODAL_UPSCALE=8 與 7 個 grafts,但掉了 V24 的 4 個關鍵 patch。
fork 中遺失的 4 個 patch
| 參數 | V24 | V25 | 理由 |
|---|---|---|---|
| MULTIMODAL_UPSCALE | 8 | 8 | 保留 |
| TAAF grafts | 0 | 7 | winframe+goalkeep+clockwatch+hudmask+clickmap+searchmap+lawbook |
| FP8 KV cache | enabled | MISSING | Fork 中遺失 |
| writable bundle copy | yes | MISSING | Fork 中遺失 |
| reasoning effort cap | yes | MISSING | Fork 中遺失 |
| noop guard verified | yes | MISSING | Fork 中遺失 |
| source bundle | jakobbrggen anim | thtennant fork | 不同 base |
-1.14 的退步
- Local mean: 未量測
- Baseline(上一版): V24 LB 2.56
- Local delta: n/a
- LB score: 1.42
7 grafts fire 但 4 patch MISSING
| Patch | 是否 fire? | Marker |
|---|---|---|
| MULTIMODAL_UPSCALE=8 | yes | Patched MULTIMODAL_UPSCALE to 8 in command 0 |
| TAAF grafts features | yes | TAAF_GRAFTS FEATURES={…} |
| Qwen3.8 model | yes | qwen3-8-27b-fp8-repacked-v1 |
| temperature set | yes | temperature’: 0.0 |
| context window set | yes | ANALYZER_CONTEXT_WINDOW = 32768 |
| vLLM server started | yes | vLLM server ready |
| FP8 KV cache | NO | 沒有 ENABLE_FP8_KV marker |
| writable bundle copy | NO | 沒有 refreshing bundle copy marker |
| reasoning effort cap | NO | 沒有 reasoning_effort marker |
| noop guard verified | NO | 沒有 hard_noop_guard marker |
加 feature 不是免費的
LB 1.42,比 V24 的 2.56 -1.14。7 個 grafts fire 但 4 個關鍵 patch 掉了。
歸因清楚:是遺失的 4 個 patch 造成退步,不是 grafts 本身。Grafts 本身可能 neutral 或微正,但掉的 4 個 patch 是 V24 winning config 的核心。具體來說:
- FP8 KV cache:沒有它,512x512 vision tokens(大 4 倍)消耗更多記憶體。有效 context window 縮小,遊戲歷史保留變少。
- Writable bundle copy:沒有它,bundle 是 read-only。某些 patch 無法寫進 bundle 目錄,靜默失敗。
- Reasoning effort cap:沒有它,reasoning effort 是 max,延遲增加。更多遊戲 timeout。
- Noop guard:沒有它,solver 可能在卡關遊戲上無限循環,浪費 9 小時預算。
加 feature 不是免費的,如果基礎退步了。V25 加了 7 個 grafts 但掉了 4 個 patch,淨效果是 -1.14 LB。
修法應該是把 7 個 grafts port 到 V24 的 bundle 上,不是 thtennant fork。V28 會用 text-only ablation 替代嘗試。
V28 的 text-only ablation
V26 與 V27 是 MM-ablation 實驗(text-only vs image-only)。V28 會在 V24 config 上做 text-only ablation,測 hidden games 是否偏好 image modality。